
Day 13 結尾說容器一重開資料就全沒了。其實沒有,之前到現在重開過好幾次,前幾天存的 key 都還在。
因為 Redis 會自己把記憶體裡的東西寫到硬碟上。RDB 是其中一種做法:在某個時間點,把整個資料庫拍成一張快照,寫成一個檔案。
rdb_changes_since_last_save(存完檔之後又改了幾筆)latest_fork_usec(最近一次複製行程花了幾微秒)以下 redis-cli 都在 db1 操作。先看檔案放在哪:
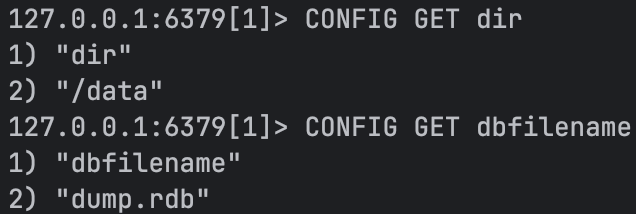
合起來是 /data/dump.rdb,Day 2 掛的那個 volume。
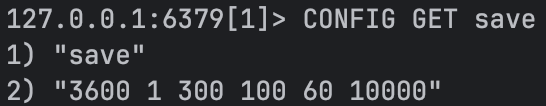
3600 1 300 100 60 10000 要兩個兩個一組看,任一條成立就存檔:
| 秒數 | 寫入筆數 | 意思 |
|---|---|---|
| 3600 | 1 | 一小時內有 1 筆寫入 |
| 300 | 100 | 五分鐘內有 100 筆 |
| 60 | 10000 | 一分鐘內有 10000 筆 |
改得越勤,存得越密。實際跑一次,先清乾淨(在主機的終端機下):
docker exec redis30days redis-cli FLUSHALL

docker exec redis30days sh -c 'rm -f /data/dump.rdb; ls -la /data'
再灌 10 萬筆 1KB(在主機的終端機下):
V=$(printf 'x%.0s' $(seq 1 1000))

for i in $(seq 1 100000); do echo "SET cache:$i $V"; done | docker exec -i redis30days redis-cli -n 1 --pipe
灌完當下查一次(在主機的終端機下):
docker exec redis30days redis-cli INFO persistence | grep rdb_changes_since_last_save

docker exec redis30days ls -la /data

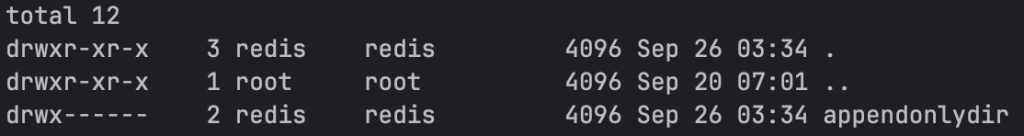
這邊規則看的是「距離上次存檔」,不是「距離這次開始灌資料」,所以不一定要等到一分鐘,如果上次存檔是一分鐘前的事,這次灌資料衝過 10000 筆的那一刻就會直接觸發,dump.rdb 可能灌到一半就冒出來。
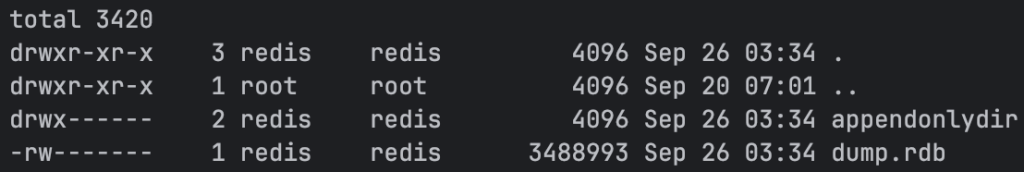
為什麼會存,log 裡寫得很明白(在主機的終端機下):
docker logs --tail 5 redis30days
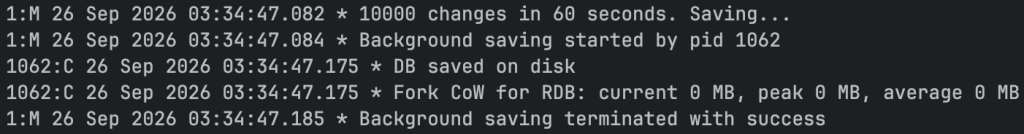
10000 changes in 60 seconds. Saving... 就是第三條規則。105MB 存成檔案只有 3.3MB,因為 RDB 是壓縮過的二進位格式。
剛才那段 log 還有兩個地方值得看:
1:M    ... * Background saving started by pid 1062
1062:C ... * DB saved on disk
1:M    ... * Background saving terminated with success
冒號前面是行程編號。1:M 是 Redis 本尊(M = master),1062:C 是它複製出來的副本(C = child),這個複製動作叫 fork。BGSAVE 就是 fork 一個自己出來,副本去寫檔案,本尊繼續收指令,所以寫檔案那一行是 1062:C 印的,不是 1:M。
SAVE 沒有這一步,主行程自己下去寫,寫完之前誰都別想動。差多少量一下就知道,開一個新的終端機讓它一直量延遲(在主機的終端機下):
docker exec -it redis30days redis-cli --latency
回到原本的終端機分別跑 SAVE 跟 BGSAVE,看數字跳到多少(輸出是最小、最大、平均,在主機的終端機下):
docker exec redis30days redis-cli SAVE

docker exec redis30days redis-cli BGSAVE

同樣 105MB,SAVE 期間最大延遲 76 毫秒,BGSAVE 只有 5 毫秒。Day 3 那個單執行緒的問題又回來了。正式環境只用 BGSAVE,SAVE 當作不存在。
不會馬上變。副本看到的是 fork 那一瞬間的記憶體,兩邊一開始共用同一份,本尊改到哪一頁,作業系統才真的複製那一頁給它,這叫 copy-on-write。
所以存檔期間寫入越多,多吃的記憶體越多,最壞情況才是兩倍。這次剛好沒人寫入,只多用了 0.9MB(在主機的終端機下):
docker exec redis30days redis-cli INFO persistence | grep rdb_last_cow_size
docker exec redis30days redis-cli INFO stats | grep latest_fork_usec
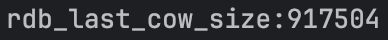
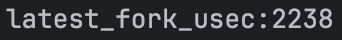
latest_fork_usec 是 fork 那一下花掉的時間,105MB 量到 2238 微秒(2.2 毫秒)。這個值跟資料量成正比,幾十 GB 的機器會到幾百毫秒,而且卡住的是主行程。
這是 RDB 最需要知道的一件事。手動存一次當起點,再寫 5 筆:
BGSAVE

INFO persistence   # rdb_changes_since_last_save:0
LASTSAVE           # 1790397145

MSET order:1 a order:2 b order:3 c order:4 d order:5 e

INFO persistence   # rdb_changes_since_last_save:5
LASTSAVE           # 1790397145,沒動
rdb_changes_since_last_save 就是「還沒進檔案的寫入筆數」。這 5 筆只在記憶體裡,而且 5 離 10000 還很遠,不會觸發存檔。這一秒斷電就是掉這 5 筆。
拔電源試試看。docker kill 是直接砍掉,不給它存檔的機會(不用 docker stop 是因為會先通知 Redis 存檔,在主機的終端機下):
docker kill redis30days && docker start redis30days
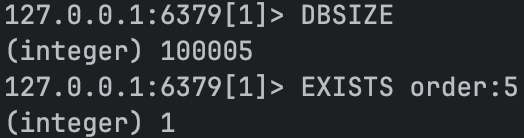
5 筆都還在。但不是 RDB 救的(在主機的終端機下):
docker logs redis30days | grep "DB loaded from append only file" | tail -n 1

Day 2 的 --appendonly yes 就是另一套持久化。如果只有 RDB,dump.rdb 裡就是那 10 萬筆,這 5 筆真的會掉。
60 10000 那條的意思是最壞情況掉一分鐘的寫入。這在金融業或電商不是掉 5 筆測試資料,是掉一分鐘的交易。SAVE 跟 KEYS * 是同一類指令,都會在正式環境卡住所有連線。stop-writes-on-bgsave-error 預設 yes)。硬碟滿了會先表現成寫入報錯,跟 Day 13 的 OOM 長得很像,要分得出來。優點也要講:檔案小、載入快(10 萬筆 0.2 秒),適合備份跟搬機器。
| Day | 主題 | 一句話 |
|---|---|---|
| 8 | Sorted Set | 自己照分數排序,排行榜跟延遲關單都靠它 |
| 9 | Bitmap / HLL | 拿精確度換記憶體,一千萬人簽到 1.25MB |
| 10 | Stream | 有 ACK 有重試的 Queue,補上 List 的三個洞 |
| 11 | 底層編碼 | 資料一大就換結構,而且換過去回不來 |
| 12 | 過期刪除 | TTL 到了不等於記憶體馬上還回來 |
| 13 | 記憶體淘汰 | 預設不淘汰,滿了直接讓寫入報錯 |
| 14 | RDB | 快照存檔,兩次快照中間的寫入會掉 |
Day 8–10 是「有什麼可以用」,Day 11–14 是「它背後在幹嘛」。後面這四天沒有一行程式碼,但真的出事的時候,八成都是這四件。
RDB 會掉一段時間的寫入,那有沒有辦法一筆都不掉?明天來看 AOF,還有為什麼「一筆都不掉」這個選項通常沒人敢開


 iThome鐵人賽
 看影片追技術